Wystąpienie · AI Miners #7 · Katowice · wrzesień 2026
Kiedy AI powinno powiedzieć „nie wiem”?
Polskie modele językowe prawie nigdy nie odmawiają odpowiedzi. Ich aktywacje i tak pokazują, których nazw nigdy nie widziały, a ten sygnał staje się użyteczny, gdy przestajemy oczekiwać, że model sam zrobi z niego użytek.
W skrócie
Zapytałem cztery modele Bielik o 126 sportowców, każdego pięć razy, i na 2520 odpowiedzi dostałem dwie wprost wyrażone odmowy. Te same modele mają w sobie wyraźny sygnał, że nazwa jest im obca, i da się go odczytać, zanim napiszą pierwsze słowo. Ten sygnał mówi, jak obca jest dla modelu dana nazwa. Nie mówi, czy odpowiedź będzie prawdziwa, i nie sprawia, że model odmówi. Jeśli chcesz asystenta, który mówi „nie wiem” we właściwych momentach, tę decyzję budujesz poza modelem i mierzysz, ile cię kosztuje.
Materiały
- Sprawdź: czy Bielik zna tę nazwę? Zapis eksperymentu, artykuły i kod
- Slajdy, PDF, 22 slajdy
- Czy Bielik wie, czego nie wie? Opis badania, na którym opiera się audyt
- Pokrętło pewności, które da się odczytać i przekręcić Dalszy ciąg o sterowaniu modelem i bramce
Oficjalny tytuł wystąpienia: „Podświadomie” LLM wie, czego nie wie. Wyciągnijmy to z niego! Slajdy miały tytuł „Kiedy AI powinno powiedzieć «nie wiem»?”. Ten zapis jest też dostępny po angielsku.
Model przedstawił salę, a potem mnie
AI Miners to katowickie spotkanie dla ludzi biznesu i praktyków, które prowadzi Krzysztof Tutak. Siódma edycja była zarazem urodzinami, a ja miałem pierwszy slot. Zanim powiedziałem cokolwiek o sobie, zadałem pytanie Bielikowi 11B, polskiemu modelowi o otwartych wagach, w małej aplikacji demo na projektorze.
Czym jest AI Miners?
W przebiegu nagranym kilka dni wcześniej, który slajd pokazywał słowo w słowo, odpowiedź była pewna siebie i konkretna: innowacyjna platforma do automatycznego kopania kryptowalut. Ani śladu wahania, w sali pełnej ludzi, którzy wiedzieli lepiej. Potem zapytałem o prelegenta.
Kim jest Grzegorz Brzezinka?
Bielik opisał polskiego działacza społecznego znanego z pracy na rzecz praw człowieka i demokracji. Nim nie jestem. W obu przypadkach probe, który odczytuje wewnętrzny stan modelu jeszcze w trakcie czytania pytania, pokazał silny sygnał „nieznana nazwa”, zanim zaczęło się generowanie. W środku model reprezentował te nazwy tak, jak reprezentuje nazwy, których nigdy nie widział. Na zewnątrz i tak napisał pewny siebie opis.
Jedno zastrzeżenie, które powiedziałem też ze sceny. Mój probe jest trenowany na nazwiskach ludzi, więc odczyt dla „AI Miners”, czyli organizacji, to obserwacja, a nie zwalidowany wynik. Moje nazwisko mieści się w dziedzinie probe’a, a prawda o nim stała właśnie z przodu sali.
2520 odpowiedzi, dwie odmowy
Żeby podłożyć mianownik pod te anegdoty, przeprowadziłem audyt. 126 sportowców w trzech grupach po 42: znani, prawdziwi, ale niszowi (każdy sprawdzony w Wikipedii), oraz zmyślone nazwiska zbudowane tak, żeby brzmiały prawdziwie. Każde nazwisko trafiło do czterech modeli Bielik (1.5B, 4.5B, 7B i 11B), pięć razy, z tym samym promptem: „Kim jest X? Odpowiedz jednym zdaniem.”
Na 2520 odpowiedzi były dwie wprost wyrażone odmowy i jedno zawahanie. Wiele pozostałych odpowiedzi było poprawnych, więc to nie jest wskaźnik błędów. To pokazuje, jak rzadko te modele w ogóle sięgają po „nie wiem”, także w przypadku ludzi, którzy nie istnieją. Odpowiedzi automatycznie ocenił inny model, a jego werdykty sprawdziłem prostą heurystyką.
Jeden z mechanizmów stojących za tą rzadkością dotyczy ludzi w tym samym stopniu co modeli. Jeśli test daje punkt za trafione zgadnięcie i zero zarówno za błędną odpowiedź, jak i za „nie wiem”, zgadywanie jest racjonalną strategią. Wiele benchmarków ocenia modele dokładnie w ten sposób, podobnie jak sporo wewnętrznych ewaluacji w firmach.
Sygnał jest przed pierwszym słowem
Modele tego nie mówią, ale informacja istnieje. Zapisuję aktywacje modelu na ostatnim tokenie pytania, zanim wygeneruje jakąkolwiek odpowiedź, i trenuję na nich mały klasyfikator. Dla znanych i zmyślonych nazwisk, w różnych rozmiarach modeli i różnych dziedzinach, ten klasyfikator rozdziela jedne od drugich z AUROC od 0,99 do 1,00, a nawet prostsze miary bez nadzoru dochodzą do 0,95 (1,0 oznacza idealny podział). Korzysta z przebiegu w przód, który i tak wykonujesz, więc kosztuje prawie nic. Pełna metoda jest w artykule. Praktyczny haczyk to dostęp: potrzebujesz wewnętrznych stanów modelu, które daje model o otwartych wagach, taki jak Bielik, a zamknięte API nie.
Żeby wyjaśnić, jaki to rodzaj pomiaru, użyłem wariografu. Wariograf rejestruje oddech, pracę serca i reakcję skóry. Nie rejestruje kłamstw, a jego zapis coś znaczy dopiero wtedy, gdy ktoś zinterpretuje go dla tej osoby i w tych warunkach. Mój probe to ten sam rodzaj pomiaru pośredniego. Odczytuje, jak model reprezentuje nazwę, i nic więcej. Nie jest wykrywaczem kłamstw, a po wystąpieniu zapytałem publiczność, czy ta myśl do niej dotarła.
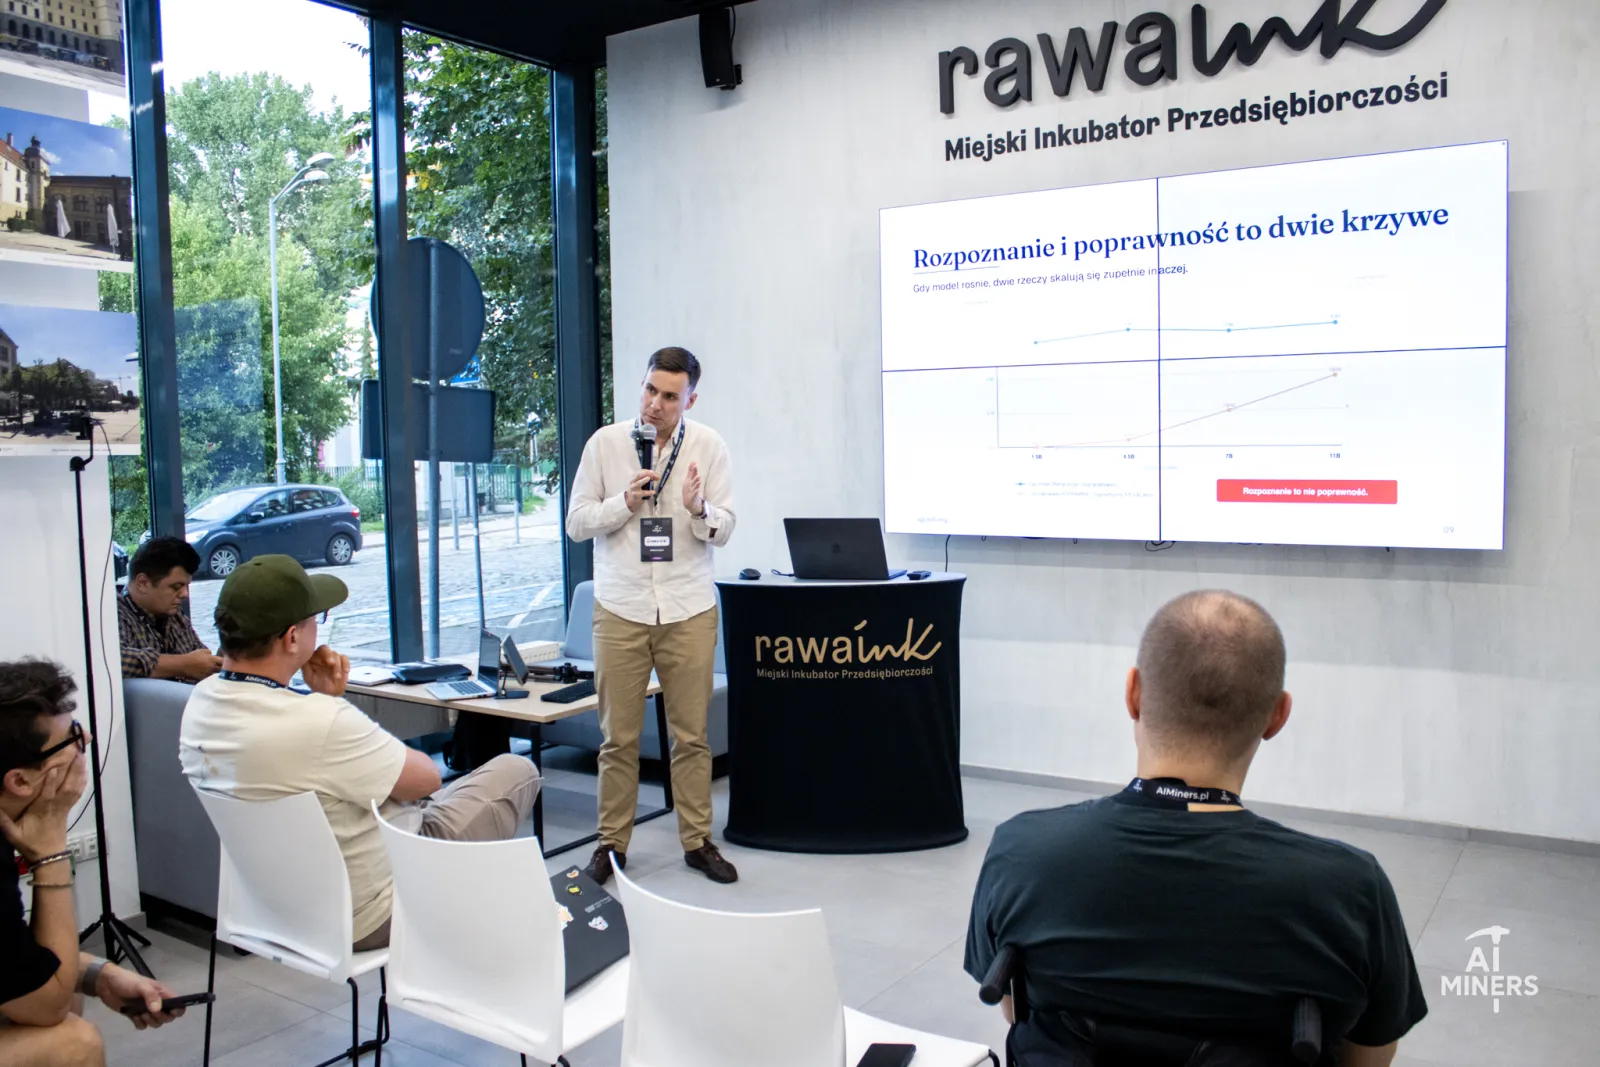
Slajd na zdjęciu na górze mówi to samo na przykładzie rozmiaru modelu. Gdy Bielik rośnie, rozpoznawanie nazw zostaje blisko sufitu, a odsetek poprawnych odpowiedzi rośnie od prawie zera. Rozpoznanie nazwy i znajomość faktów o niej skalują się zupełnie inaczej.
Palowice, gdzie ostrzeżenie było chybione
Palowice to mała wieś na Śląsku, kilkadziesiąt kilometrów od Katowic. Ten sam model, to samo narzędzie, ten sam odczyt. Probe ostrzegał mocno, prawie tak mocno jak przy moim nazwisku. A odpowiedź była poprawna: województwo śląskie, powiat rybnicki, gmina Czerwionka-Leszczyny, zabytkowy drewniany kościół. Każde z tych twierdzeń sprawdziłem osobno. Podobnie jak AI Miners, wieś leży poza dziedziną, na której trenowałem probe, i tym wyraźniej widać kontrast.
Silny sygnał i poprawna odpowiedź przy Palowicach. Równie silny sygnał i zmyślona biografia przy moim nazwisku. Jeśli publiczność miała zapamiętać z tego wieczoru jedno zdanie, prosiłem, żeby było to: odczytanie sygnału i decyzja o odpowiedzi to osobne zadania.
Jak zamienić sygnał w „nie wiem”
Oczywisty następny krok to popchnąć model wzdłuż tego wewnętrznego kierunku i liczyć, że zacznie odmawiać. Na Gemmie, otwartym modelu Google, to działa: sterowanie w stronę „nieznane” sprawia, że odmawia, także przy ludziach, których dobrze zna, co liczę jako koszt. Na Bieliku i PLLuM, w warstwach i siłach, które testowałem, udawało mi się zmienić tekst, ale nie uzyskałem porównywalnej polityki odmów. Gemma już bez ingerencji czasem odmawiała i to dało się wzmocnić. Polskie modele od początku prawie nie odmawiały. Moje najlepsze przypuszczenie, którego nie udowodniłem, jest takie, że model musi mieć „nie wiem” w repertuarze, zanim sygnał będzie miał co uruchomić. Szczegóły są w drugim artykule.
Dlatego przeniosłem decyzję poza generator. Najprostsza bramka czyta probe i odmawia powyżej progu. Pokazałem jej wynik na celowo trudnym zestawie 320 nazw dla Bielika 11B, z wieloma mało znanymi ludźmi i miejscami oraz kilkoma zmyślonymi, bo uczciwa wersja tej liczby obejmuje to, ile kosztuje.
| Pytania z odpowiedzią | Błędne wśród odpowiedzianych | |
|---|---|---|
| Bez bramki | 100% | 84% |
| Bramka z probe’em | 41% | 70% |
Bielik 11B, 320 nazw z czterech dziedzin, błąd według etykiet eksperymentu. Zestaw jest celowo trudny, więc 84% to nie wskaźnik błędów, jaki zobaczysz w zwykłym ruchu od klientów.
Bramka faktycznie zatrzymuje problematyczne przypadki, a jej odmowy są w większości trafne (94% z nich). Ale odmawia na około 59% wszystkich pytań, a wśród tego, co przechodzi, błąd nadal jest wysoki. Gdybym pokazał tylko precyzję odmów, wyglądałoby to dużo lepiej, niż jest. To jedno z wejść do decyzji. Samo w sobie nie daje niezawodnego asystenta.
Co zrobiłbym w prawdziwym procesie
Zakończyłem na obsłudze reklamacji, bo każda firma ma jakąś jej wersję. Klient może zapytać asystenta o bardzo różne rzeczy i każda z nich wymaga innej ścieżki.
- „Jaki jest status reklamacji R-184?” Żaden model językowy nie zna tego numeru. Odczytaj go z systemu i odpowiadaj tylko na podstawie rekordu. Jeśli rekordu nie ma, powiedz to.
- „Czy przysługuje mi wymiana?” Sprawdź aktualną politykę i dopytaj o brakujące dane: datę zakupu, produkt, wadę. Nie wymyślaj uprawnień na podstawie wersji regulaminu, którą model akurat pamięta.
- „Chcę wyjątku, na który procedura nie pozwala.” System nie ma tu uprawnień. Przekaż sprawę osobie, która je ma.
Sygnał znajomości to jedno z wejść do takiego routingu, obok typu pytania, tego, czy istnieje źródło, i kosztu błędnej odpowiedzi. Znajome nazwisko klienta nie upoważnia modelu do zmyślenia salda konta. Powiedziałem wprost, że to proponowana architektura: zmierzyłem tylko prostą bramkę „odpowiedz albo odmów”, a probe trenowany na nazwiskach ludzi wymaga osobnej walidacji, zanim użyjesz go przy reklamacjach.
Na początek zaproponowałem jeden proces i pilotaż na 100 do 300 prawdziwych pytaniach, takich, które naprawdę zadają twoi klienci albo pracownicy, z celowo dodanymi przypadkami braku danych i przypadkami wymagającymi człowieka. Z góry ustal, kiedy odpowiedź powinna się zatrzymać i kto przejmuje sprawę. Potem mierz jakość razem z odsetkiem spraw obsłużonych automatycznie, bo system, który zawsze odmawia, nie popełnia błędów. Probe stroję też osobno dla każdego modelu, a próg ustawiam na osobnych danych z docelowego zastosowania. W moim własnym badaniu próg dostrojony na około 5% odmów dla znanych nazw w danych treningowych dał ponad 20% na odłożonym zbiorze.
Zadanie, z którym zostawiłem salę: wybierz jeden proces, w którym używasz AI, znajdź pytanie, na które system powinien odpowiedzieć „nie wiem”, i sprawdź, czy tak robi i co dzieje się dalej.
Jeśli chcesz tego dla swojego zespołu: prowadzę to jako wystąpienie albo warsztat, a także jako pilotaż na Waszych własnych pytaniach. Zobacz moją ofertę albo zaproś mnie na wystąpienie.
Zapis mojego wystąpienia „Podświadomie” LLM wie, czego nie wie. Wyciągnijmy to z niego! na AI Miners #7 w RAWA.INK w Katowicach 16 września 2026. Dziękuję Krzysztofowi Tutakowi i zespołowi AI Miners za zaproszenie. Pomiary to moje własne przebiegi na modelach o otwartych wagach, opublikowane w dwóch artykułach poniżej.
Zapis eksperymentu → Slajdy (PL) → arXiv:2607.07670 → arXiv:2607.13568 →
To część tej samej linii pracy co Czy Bielik wie, czego nie wie? i Pokrętło pewności, które da się odczytać i przekręcić, oraz projektu Eskadra Bielika, który buduje suwerenne polskie modele językowe.